电池机器人自主抓取与分拣的实现
摘要:这个项目把头部相机、YOLOv5、圆柱图像几何、机器人坐标转换、六轴机械臂和灵巧手连接起来,完成同规格直立测试件的识别、接近、抓取、分类投放和返回。升级的关键,是让当前图像决定抓取位置,而不是由槽号选择一组固定坐标。实际开发也暴露了几条容易混淆的边界:检测框不等于抓取点,RGB-D相机不意味着运行链一定使用深度,位置标定不等于完整六维手眼标定,控制器接受指令也不等于物体已经入盒。本文沿真实源码解释这些接口,并用历史评估、真机日志和失败记录界定系统已经做到什么、还缺什么。
关键词:机器视觉;YOLOv5;RealSense D435;眼在手外;圆柱几何;机械臂;灵巧手;视觉抓取;Web控制;工程复盘。
版本范围:调查基线为2026年10月28日本地
main分支提交c3e02aef5319cc72c21efbf0218d8c5c89fdbc60。当前正式运行描述文件仍指向v24-fix2;最新提交另增加了v25语音、文字和HTTPS候选层。二者共享原有分拣动作,但验证范围不同。本文编写期间只读源码与既有证据,没有启动相机、SDK、机器人、云接口或项目测试。历史数据按原版本引用,不作为最新版本重新验收。
升级要解决的具体问题
项目面向电池外形测试件的自动分拣教学与实验。人工逐件判断和搬放需要持续关注工作区;若未来迁移到真实废旧电池,还涉及带电、破损和材料接触等额外问题。当前实验使用断电圆柱或空壳,验证的是视觉与执行的衔接,没有开展真实废旧电池的危险品处理验证,也没有通过颜色判断电池电化学状态。
原学校方案已经具备机械臂抓取、灵巧手动作和料盒投放能力。它的抓取位置由工作索引和固定间距计算,颜色任务也可以由预设位置决定。下面是保留在参考目录中的历史实现;它是比较基线,不是当前视觉入口。
源码 S01 · deployment/school_bin_reference/ohandtest.py · grasp_battery · L375–L412 · 完整函数;历史学校参考实现,当前不通过此函数计算视觉目标。
def grasp_battery(left_arm, right_arm):
    x, y  = divmod(GlobalVar.CURRENT_WORK_INDEX, 3)
    start_position = copy.deepcopy(GlobalVar.ARM_GRASP_POS)
    start_position[2] = start_position[2] + 0.080
    target_position = copy.deepcopy(GlobalVar.ARM_GRASP_POS)

    start_position[0] = start_position[0] - x * GlobalVar.X_BIAS
    target_position[0] = target_position[0] -  x * GlobalVar.X_BIAS

    # start_position[1] = start_position[1] - y * GlobalVar.Y_BIAS
    # target_position[1] = target_position[1] - y * GlobalVar.Y_BIAS
    start_position[1] = start_position[1] + y * GlobalVar.Y_BIAS
    target_position[1] = target_position[1] + y * GlobalVar.Y_BIAS

    left_arm.grasp_battery(start_position, target_position)
    left_arm.move_to(GlobalVar.HIGHT_POS)
    print("MOVE_TO IS RUNNING !!!!!!!!!!!")
    for pos in GlobalVar.SCAN_BATTERY_POS:
        left_arm.scan_battery(pos)
        time.sleep(0.5)
        requests.post(GlobalVar.INSPECT_URL, json={})
        time.sleep(1.5)
    left_arm.move_to(GlobalVar.SCAN_BATTERY_RESTART_POS)
    # 检测电池颜色放在相对应的分拣框内
    if GlobalVar.battery_color == "WHITE":
        left_arm.palce_object_recycle_area(GlobalVar.RECYCLE_WHITE_AREA)
        # print("True" + GlobalVar.battery_color)

    elif GlobalVar.battery_color == "RED":
        left_arm.palce_object_recycle_area(GlobalVar.RECYCLE_RED_AREA)
        # print("True" + GlobalVar.battery_color)
    else:
        left_arm.palce_object_recycle_area(GlobalVar.RECYCLE_AREA)
        # print("True" + GlobalVar.battery_color)

    left_arm.move_to_idle_position()
    GlobalVar.CURRENT_WORK_INDEX = GlobalVar.CURRENT_WORK_INDEX + 1
    requests.post(GlobalVar.CLEAR_INSPECT_URL, {})
CURRENT_WORK_INDEX先分解成行列,再把固定偏移加到ARM_GRASP_POS。因此,在这个函数里改变抓取位置的直接因素是索引,而不是本轮相机观察到的电池中心。它适合已知摆放规则的演示,不能单凭同时显示了识别画面就称为视觉驱动抓取。
升级后的要求更具体:在允许的工作区内改变测试件位置,重新观察后应生成新的目标;一次启动应能连续处理多个目标;黑色、红色和白色应按当前检测类别投放;观察画面应持续展示,操作者可以从网页控制任务。
这里的“自主”有明确范围。当前支持外径45.8mm、高98mm、直立且处于两种已测量支撑高度的测试件。物体可以改变平面位置,但相机、机器人、工作板之间的安装关系需要保持,近远腕姿和转运走廊仍来自现场记录。任意尺寸、任意高度、任意朝向和未知障碍环境,尚不在已经验证的能力里。
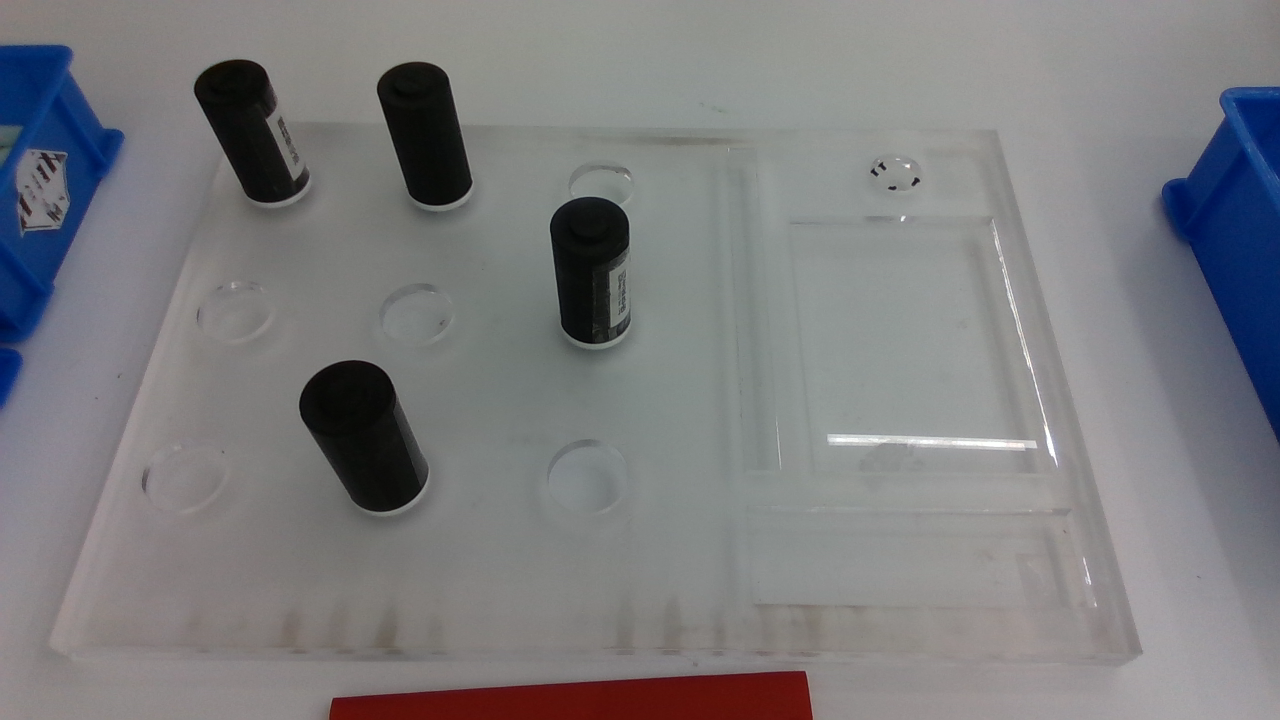
图1:2026年10月24日四件黑壳批次的原始相机帧,未重绘、未生成。画面展示九槽工作板、四个测试件和两侧料盒。它证明现场布局,不单独证明抓取精度。图像来源、内外层文件名及SHA256见图像溯源记录。
设备、环境与当前项目结构
硬件参数:哪些来自配置,哪些来自现场
灵巧手协议、身份和电流配置可从battery_hand_verified_profile.json、school_device_identity.py与hand_bus_startup.py交叉核对。配置保存的六通道电流上限是1299mA,这只是本机保存值,不是本文推导的通用安全电流。
软件版本不能从目录名推断
另一个历史Linux离线验证环境记录了Python 3.10.21、PyTorch 2.5.1+cpu、OpenCV 4.10.0、NumPy 1.26.4。它用于推理回放,不能代替上表的真机环境,更不能据此声称机器人装有CUDA或GPU。
当前目录树
下面按入口和职责列出实际保留的核心文件,省略历史证据、备份和非运行教学材料。较旧版本号的模块仍可能是当前依赖,判断依据应是导入关系和发布清单,而不是名字新旧。
battery_grasp_ws/
├── README.md / README.en.md
├── requirements-web.txt
├── deployment/
│   ├── CURRENT_RELEASE.json
│   ├── run_visual_task_control_v24.py        当前网页启动入口
│   ├── visual_task_control_v24.py            HTTP、任务与状态
│   ├── visual_task_dashboard_v24.html        网页UI
│   ├── visual_live_camera_v24.py             相机唯一采集端与同帧服务
│   ├── visual_detection_confirm_v24.py       2秒可见性统计
│   ├── run_visual_pick_sort_live_v24.py      批次父进程
│   ├── visual_pick_sort_live_v24_vision.py   当前视觉采集入口
│   ├── known_cylinder_geometry*.py          黑壳/轴向几何
│   ├── known_cylinder_color_v23.py          红白轮廓
│   ├── visual_equal_height_plane.py         射线与工作面求交
│   ├── visual_pick_sort_v22_auto_height.py  两层高度判断
│   ├── visual_pick_sort_v22_source.py       near/far选择及目标映射
│   ├── visual_pick_sort_v23_worker.py       机械臂和手部动作
│   ├── hand_bus_startup.py                  末端通信初始化
│   ├── color_bin_adjustment_v23.json        投放修正与抬升配置
│   ├── task_control_ros_v24.py              可选ROS桥
│   ├── run_visual_task_control_v25.py       语音/文字/HTTPS候选入口
│   ├── voice_interaction_v25.py             任务意图与确认
│   ├── voice_web_server_v25.py              HTTPS访问层
│   ├── voice_panel_v25.js / voice_audio_worklet_v25.js
│   └── *-files.sha256                      运行文件校验
├── src/battery_grasp/
│   ├── scripts/yolo_worker.py              独立模型进程
│   ├── src/battery_grasp/jit_inference.py   TorchScript推理
│   ├── src/battery_grasp/inference_client.py
│   ├── config/yolo_v3_calibrated.yaml
│   └── models/                             本机模型;公开源码不附权重
├── calibration/                            运行机器专属资产,不公开发布
├── captures/                               原图、通信与会话结果,运行时产生
├── docs/                                   说明、进度、验收与维护记录
├── tools/release/                          精简发布与运行包构建
└── technical_blog/                         本文及可追溯附件
calibration/和captures/在这里表示运行资产目录,不表示公开仓库克隆后就自带这些数据。资产说明列出了权重、设备SDK、标定和绑定的恢复要求。
系统如何把图像交给动作
模块与数据流
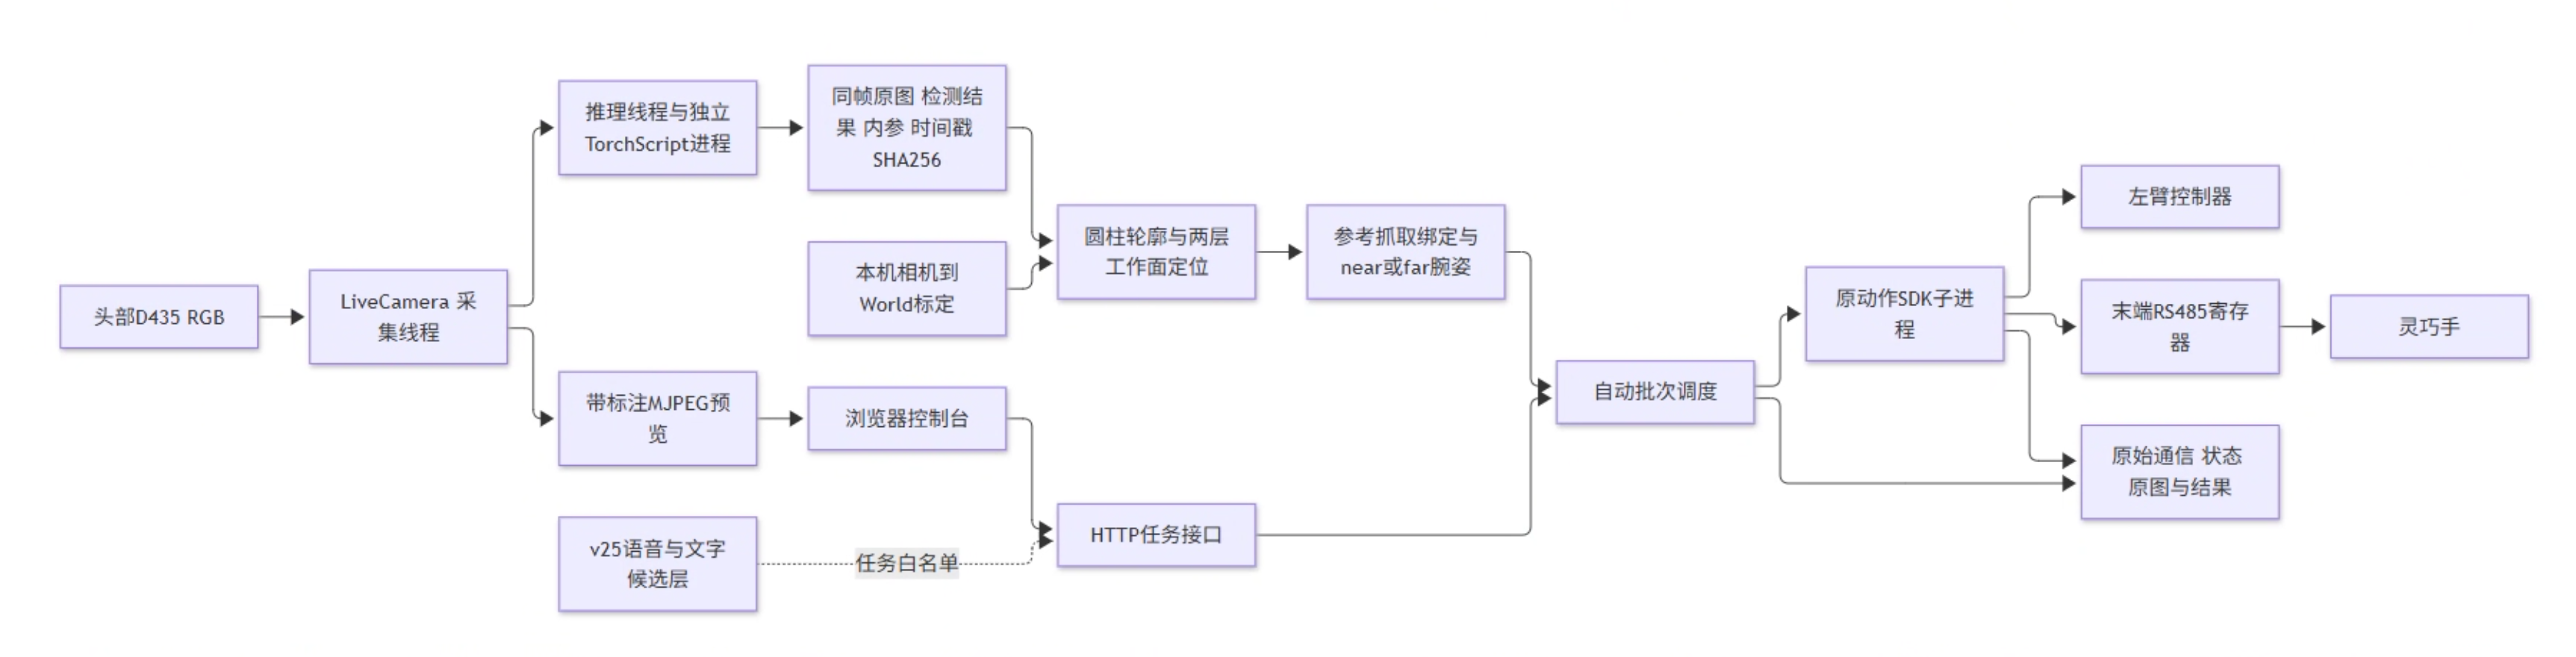
持续运行的是相机采集、推理和Web状态服务;自动抓取需要用户发起任务。网页不直接下发关节角。任务父进程负责选择当前目标,动作子进程只接收已经生成并带有来源的请求。末端通信仍经机械臂控制器转发,不由浏览器接触RS485。
一轮完整业务流程
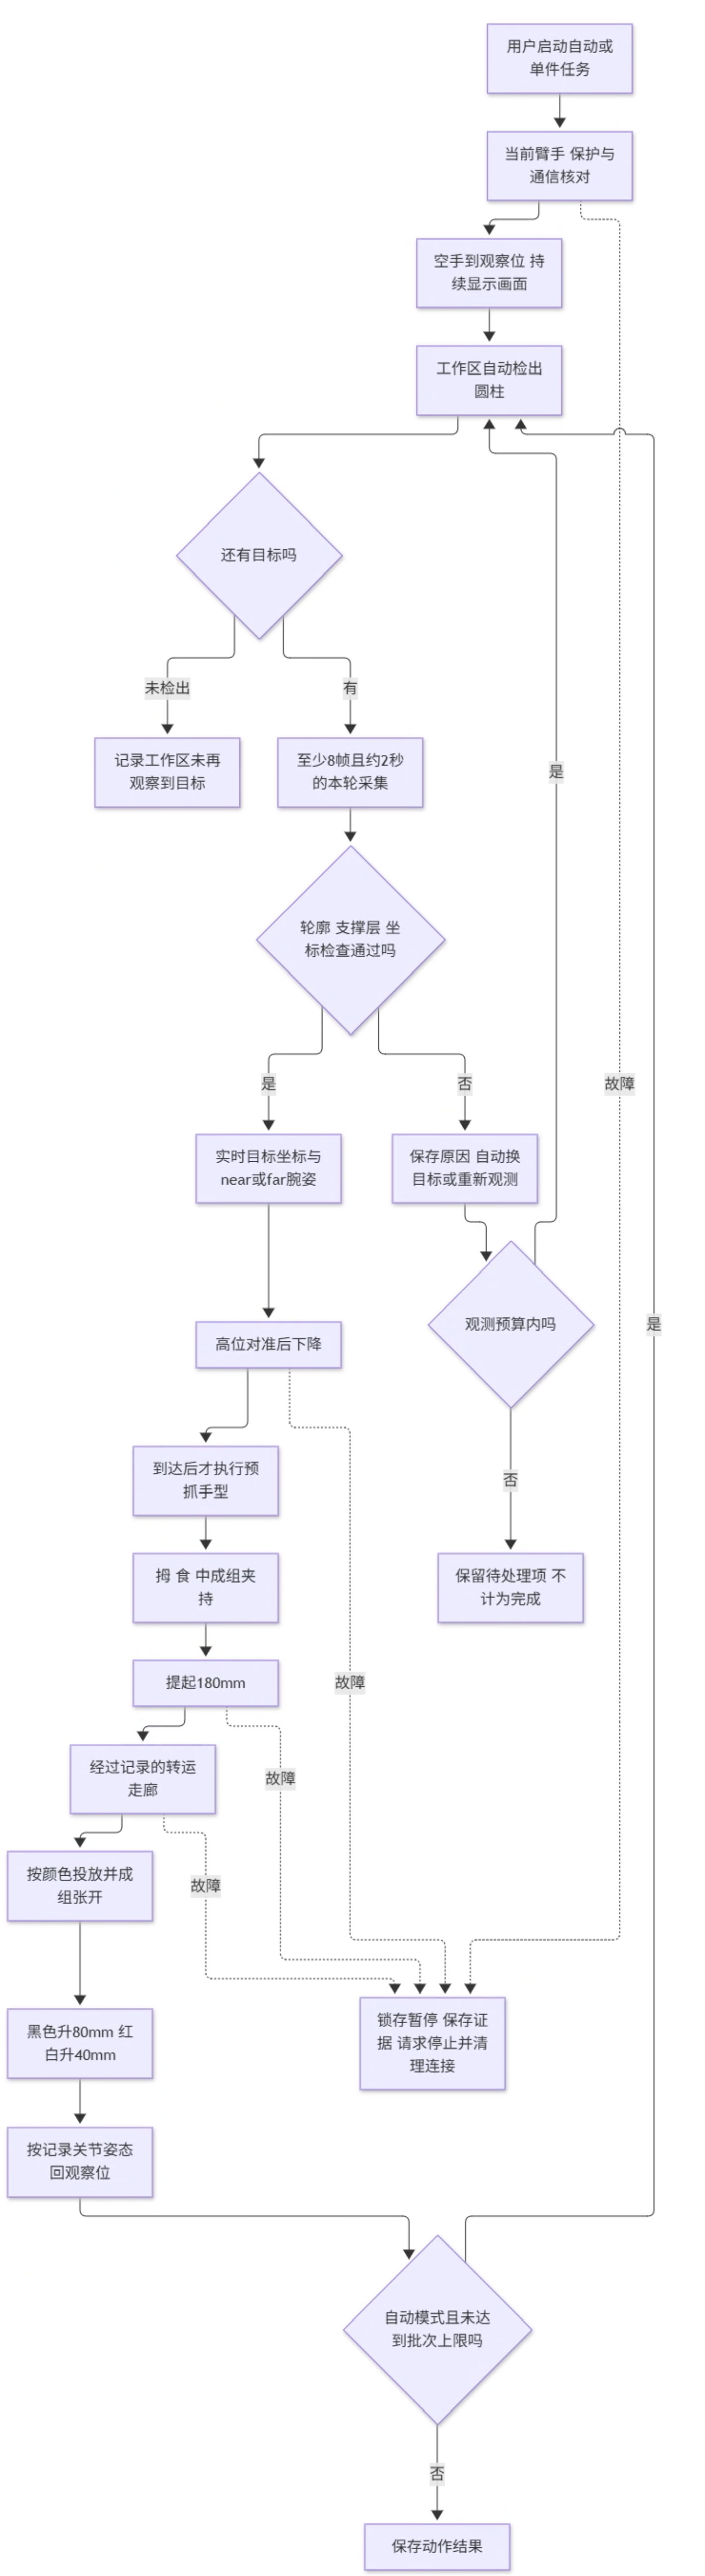
“工作区未再观察到目标”仍是视觉结论;“动作结果完成”是控制流程结论。当前缺少独立传感器确认每件物体确实入了正确盒,因此二者不能直接合并成工业分拣成功率。
目标检测:训练、阈值和推理边界
数据与模型的真实选择过程
运行模型来自YOLOv5s v3,历史记录选择的是epoch 27的last.pt。曾使用含v1字样的旧文件名,但文件内容哈希属于v3;后续部署导出为battery_v3_camera.torchscript。这也是保留文件哈希而不只记文件名的原因。
保留的训练库yolov5s.yaml使用Conv、C3、SPPF骨干及上采样、Concat融合,检测头输出P3/8、P4/16、P5/32三个尺度;深度和宽度倍率为0.33、0.50。该文件的nc: 80是通用模板,部署任务实际是下面列出的四类,不能照抄成80类电池识别。模板、训练协议和历史报告均随本文保留了原始副本,见证据索引。
v3协议记录从v1最佳权重初始化,学习率0.0005,最多60轮、patience 20;减少mosaic并进行亮度/饱和度增强。历史划分为118张训练、28张验证、4张测试,实际训练27轮。4张测试只含黑色和方形,初始化还见过部分旧验证图,因此早期零误检/漏检只能作为已有素材回归,不能代表独立泛化。部署选择last而非第7轮best,也涉及新增训练素材复核,选择过程的局限必须与结果一起保留。
历史v4试验并非没有训练。报告记录了289张训练图像、123张验证图像和424个验证目标;实际训练26轮,最佳模型在第1轮,采用v3权重微调。验证标注曾由模型建议后再修订,且画面来自相近工作台。即使没有完全相同图像同时进入训练和验证,仍不能把它称为独立场景的无偏泛化评估。
最终保留v3,理由是按部署阈值重新运行实际推理worker后,v3得到423 TP、7 FP、1 FN,而v4为423 TP、15 FP、1 FN。v4的某些总体训练指标略有提高,并没有转化为本场景各类别误检同时减少。完整历史材料保存在训练报告和阈值评估报告,它们是历史报告,不是本文新做的实验。
输入、模型输出与类别
源码 S02 · src/battery_grasp/src/battery_grasp/jit_inference.py · BatteryDetector.__init__ · L9–L17 · 完整函数;当前TorchScript加载。
    def __init__(self, repository, weights, device='cpu', confidence=.25, iou=.45, square_confidence=None, class_confidences=None):
        if device == 'auto': device='cuda:0' if torch.cuda.is_available() else 'cpu'
        if str(device).isdigit(): device='cuda:'+str(device)
        self.device=torch.device(device)
        self.model=torch.jit.load(str(weights),map_location=self.device).eval()
        self.confidence,self.iou=confidence,iou
        self.class_confidences=class_confidences or [confidence,confidence,confidence,square_confidence if square_confidence is not None else confidence]
        if len(self.class_confidences)!=4 or any(not confidence<=v<1 for v in self.class_confidences):
            raise ValueError('Invalid class thresholds')
构造函数将权重载入指定设备并切换到评估模式。auto会根据PyTorch实际可用情况选择CUDA或CPU;源码具有这个分支,不代表现场已经验证GPU推理。class_confidences必须有四项,并且不能低于基础置信度。
源码 S03 · src/battery_grasp/src/battery_grasp/jit_inference.py · BatteryDetector.detect · L19–L53 · 完整函数;当前推理与NMS。
    def detect(self,bgr):
        if bgr is None or bgr.dtype!=np.uint8 or bgr.ndim!=3 or bgr.shape[2]!=3: raise ValueError('Expected uint8 BGR image')
        h,w=bgr.shape[:2];r=min(640/h,640/w)
        nw,nh=round(w*r),round(h*r)
        dw,dh=(640-nw)%32/2,(640-nh)%32/2
        im=cv2.resize(bgr,(nw,nh)) if (nw,nh)!=(w,h) else bgr
        im=cv2.copyMakeBorder(im,round(dh-.1),round(dh+.1),round(dw-.1),round(dw+.1),cv2.BORDER_CONSTANT,value=(114,114,114))
        tensor=torch.from_numpy(np.ascontiguousarray(im.transpose(2,0,1)[::-1])).to(self.device).float().unsqueeze(0)/255
        with torch.inference_mode(): prediction=self.model(tensor)[0].cpu().numpy()
        prediction=prediction[prediction[:,4]>self.confidence]
        if not len(prediction): return []
        scores=prediction[:,5:]*prediction[:,4:5]
        classes=scores.argmax(1);conf=scores[np.arange(len(scores)),classes]
        valid=conf>self.confidence;prediction,classes,conf=prediction[valid],classes[valid],conf[valid]
        boxes=np.concatenate((prediction[:,:2]-prediction[:,2:4]/2,prediction[:,:2]+prediction[:,2:4]/2),axis=1)
        order=np.argsort(-conf,kind='stable')[:30000];keep=[]
        while len(order) and len(keep)<1000:
            i=order[0];keep.append(i);others=order[1:]
            lo=np.maximum(boxes[i,:2],boxes[others,:2]);hi=np.minimum(boxes[i,2:],boxes[others,2:])
            area=np.maximum(hi-lo,0).prod(1)
            overlap=area/((boxes[i,2:]-boxes[i,:2]).prod()+(boxes[others,2:]-boxes[others,:2]).prod(1)-area+1e-12)
            order=others[(classes[others]!=classes[i])|(overlap<=self.iou)]
        result=[]
        # Match YOLO scale_boxes: padding is computed from the actual tensor dimensions.
        gain=min(im.shape[0]/h,im.shape[1]/w)
        pad_x,pad_y=(im.shape[1]-w*gain)/2,(im.shape[0]-h*gain)/2
        for i in keep:
            c=int(classes[i]);confidence=float(conf[i])
            if confidence<self.class_confidences[c]: continue
            x1,y1,x2,y2=boxes[i]
            x1,x2=np.rint(np.clip((np.array([x1,x2])-pad_x)/gain,0,w)).tolist()
            y1,y2=np.rint(np.clip((np.array([y1,y2])-pad_y)/gain,0,h)).tolist()
            result.append(dict(class_id=c,class_name=NAMES[c],category=CATEGORIES[c],grasp_supported=c!=3,confidence=confidence,
                               u=(x1+x2)/2,v=(y1+y2)/2,bbox=[x1,y1,x2-x1,y2-y1]))
        return result
输入是uint8三通道BGR图像。代码按最长边640等比缩放,再以32的倍数约束补边,因此实际张量不必恰好640×640。颜色转为RGB、维度转成CHW后归一化到0~1。输出置信度由目标存在概率与类别概率相乘,随后执行按类别的贪心NMS,最后把框还原到原图坐标。
基础过滤阈值为0.25,NMS IoU为0.45。这里的颜色是外观类别,不能推导电池是否损坏、是否充电或应如何化学回收。
yolo_worker.py把模型放到独立Python进程中,父进程经JSON行协议发送PNG图像,接收检测结果。这样可以明确指定推理解释器,也把普通输出与协议输出分开。inference_client.py使用请求锁、读取线程和队列;纯推理子进程超时可以终止,但这不等于可以同样粗暴地杀死一个正在控制带载机械臂的进程。
为什么框稳定,定位仍可能不稳定
检测只回答“这个区域像哪类物体”。抓取定位还要恢复圆柱顶端和轴向,轮廓上的反光、标签、阴影和亚克力背景都可能改变拟合。框变化几像素可能使后续ROI截到不同边界;反过来,框几乎不动,也可能有顶缘的亚像素变化。
当前未把YOLO框中心直接作为抓取点。黑壳用圆柱顶端外缘及物体轮廓约束;红白增加彩色前景提取。定位检查失败时,调度器保存原图和原因,重新观察或轮换目标,而不是用上一件目标坐标补位。这个策略避免把坏测量发送给机械臂,但也带来了后文记录的“看得到却不抓”的可用性问题。
从RGB-D诊断到当前RGB定位
深度方法确实存在,但不是当前网页抓取的数据源
项目早期有深度预览与World坐标诊断。基本反投影关系为:
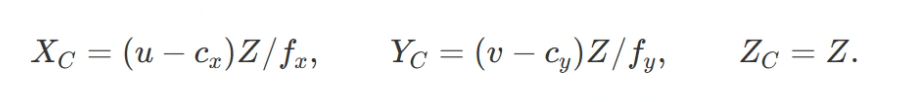
实现通过RealSense反投影接口处理相机模型,不应把上面的理想针孔公式当作绕过畸变参数的理由。深度图需要与选定RGB像素对齐,距离单位也必须从设备尺度转成米。
源码 S04 · deployment/depth_preview.py · measure · L5–L24 · 完整函数;保留的深度诊断函数,当前网页抓取未使用深度流。
def measure(depth, scale, u, v, intrinsics, deproject):
    result = dict(depth_valid=False, position_optical_m=None, execution_ready=False)
    h, w = depth.shape
    if not np.isfinite([scale, u, v]).all() or scale <= 0 or not (0 <= u < w and 0 <= v < h):
        return dict(result, depth_reason='Invalid pixel or depth scale')
    x, y = int(u), int(v)
    patch = depth[max(0,y-3):min(h,y+4), max(0,x-3):min(w,x+4)].astype(float)*scale
    valid = patch[np.isfinite(patch) & (patch >= .15) & (patch <= 3.0)]
    result['depth_valid_fraction'] = float(valid.size/patch.size)
    if valid.size < 5 or valid.size/patch.size < .5:
        return dict(result, depth_reason='Insufficient valid depth')
    z = float(np.median(valid))
    spread = float(np.percentile(valid,90)-np.percentile(valid,10))
    result.update(depth_m=z, depth_spread_m=spread)
    if spread > .04:
        return dict(result, depth_reason='Depth edge or unstable surface')
    point = [float(p) for p in deproject(intrinsics, [float(u),float(v)], z)]
    if not np.isfinite(point).all():
        return dict(result, depth_reason='Invalid deprojection')
    return dict(result, depth_valid=True, position_optical_m=point, depth_reason='')
这是depth_preview.py中的诊断函数,不属于当前抓取入口实际采集的深度流。它读取像素附近7×7区域,筛掉无效值和0.15~3m以外的数据,要求有效点数量及比例满足条件;用中位数取深度,并以P90-P10检查局部离散程度。返回中的execution_ready=False明确限制了用途:一个表面点没有自动成为TCP目标。
当前相机入口只启动颜色流
源码 S05 · deployment/visual_live_camera_v24.py · LiveCamera._capture · L32–L66 · 完整函数;当前相机采集与资源释放。
    def _capture(self):
        pipeline = None
        try:
            import numpy as np
            import pyrealsense2 as rs
            pipeline = rs.pipeline()
            config = rs.config()
            config.enable_device('344322075008')
            config.enable_stream(rs.stream.color, 1280, 720, rs.format.bgr8, 30)
            profile = pipeline.start(config)
            intr = profile.get_stream(rs.stream.color).as_video_stream_profile().get_intrinsics()
            with self.lock:
                self.intrinsics = dict(fx=intr.fx, fy=intr.fy, ppx=intr.ppx, ppy=intr.ppy,
                    coeffs=list(intr.coeffs), model=str(intr.model), width=intr.width,
                    height=intr.height, serial='344322075008')
                self.lock.notify_all()
            while not self.closing.is_set():
                color = pipeline.wait_for_frames(5000).get_color_frame()
                if not color:
                    continue
                image = np.asanyarray(color.get_data()).copy()
                with self.lock:
                    self.image, self.frame = image, int(color.get_frame_number())
                    self.timestamp_ms, self.captured = float(color.get_timestamp()), time.monotonic()
                    self.lock.notify_all()
        except Exception as exc:
            with self.lock:
                self.camera_error = repr(exc)
                self.lock.notify_all()
        finally:
            if pipeline is not None:
                try:
                    pipeline.stop()
                except Exception as exc:
                    self.camera_error = 'camera cleanup: ' + repr(exc)
LiveCamera._capture明确调用的是rs.stream.color。内参来自实际启动的颜色流,图像拷贝和单调时钟时间一起存入共享状态。异常会写入camera_error,退出时停止pipeline。保留的设备序列号是本机绑定信息,复现者应恢复自己相机与标定的匹配关系。
因此,不能把当前系统描述成“检测框中心读取D435深度后直接抓取”。现阶段采用的是已知圆柱尺寸、RGB轮廓、相机外参与两层支撑面约束。D435有深度能力,但当前链没有消费该深度流。
历史上对同一批六组位置,RGB-D路线只有1/6满足5mm判据,最大误差约7.498mm;图案PnP位置一致性为6/6,最大约3.431mm。复核记录没有证明深度误差的单一根因,也没有证明增加一个固定偏置就能修复。当前方案是约束任务模型的工程取舍,而不是已经解决了自由三维深度测量。
标定得到的究竟是什么
固定相机、运动标定板与未知安装偏置
相机在机器人头部,采样期间头部不动;ArUco板随机械臂末端移动。这属于眼在手外的安装关系。项目使用100mm、ID 0、DICT_4X4_50标记,记录相机看到的图案位姿与机械臂当前位姿。
完整六维手眼标定曾出现超差,之后保留的是位置候选。该候选优化相机旋转3个参数、平移3个参数及末端坐标系中的标记中心3个参数,总计9个自由参数。位置残差可以写成:
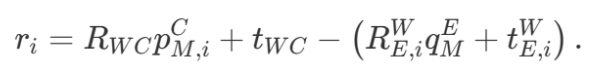
其中,PCM,i来自图像PnP;机械臂给出RWE,i,tWE,i;qEM是未知但固定的标记中心偏置。支架安装不必与法兰轴恰好对齐,关键是采样期间板面平整、尺寸正确、与末端刚性连接。纸张鼓起、支架弯曲或采样中相对滑动,会破坏这个模型。
候选使用16组FIT,拟合最大位置残差约4.084mm;另有六组图案位置复核最大约3.431mm。候选参数与独立位置复核保留了来源。这里的“独立”是没有加入那16组拟合,不等于使用外部高精度测量仪建立了真值。
相机坐标到World坐标
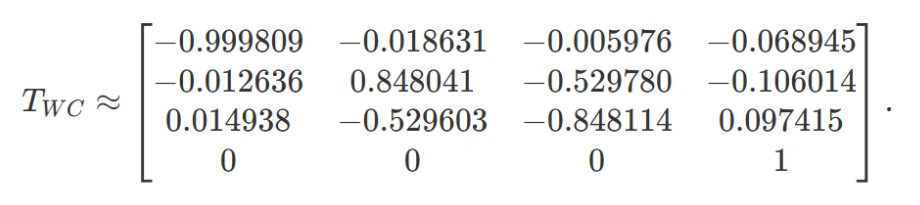
保存的变换矩阵,以下仅显示便于阅读的舍入值,程序读取JSON中的完整精度:
平移单位为米,方向为相机点到World点:
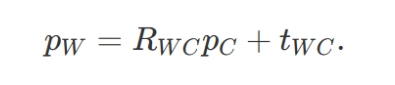
当前几何入口读取并核对冻结候选、相机上下文与来源哈希,再变换候选顶端中心。它不允许把六组验证数据重新当作拟合数据,也不把曾失败的RGB-D结果改写成通过。坐标转换的诊断模块world_coordinates.py同样区分可见表面点和抓取TCP。
冻结候选文件仍保留full6D_handeye_pass=False、position_validation_pass=False和diagnostic_pass=False,后续六组图案位置的一致性资格由独立证据文件保存。当前入口核对的是这一组合条件,不能删掉旧失败字段后宣布完整标定通过。
源码 S06 · deployment/visual_pick_sort_live_v24_vision.py · main · L128–L132 · 连续截取,非完整函数;当前视觉入口的连续片段。
        k=np.array([[intr.fx,0,intr.ppx],[0,intr.fy,intr.ppy],[0,0,1.]],float)
        if (k.tolist()!=candidate['source_context']['K'] or list(intr.coeffs)!=candidate['source_context']['distortion']
                or str(intr.model)!=candidate['source_context']['distortion_model'] or any(intr.coeffs)):
            raise ValueError('Camera intrinsics changed; no assumed compensation')
        transform=np.asarray(candidate['world_from_camera'],float)
这段从当前网页视觉入口截取:实测颜色流内参、畸变模型必须与候选上下文一致,随后从JSON读取world_from_camera。它不是每次运行现场重新拟合一个矩阵。
源码 S07 · deployment/visual_pick_sort_live_v24_vision.py · main · L314–L326 · 连续截取,非完整函数;当前几何候选到World的连续片段。
                    item['geometry']=geometry
                    if geometry['geometry_candidate_available']:
                        chosen=geometry['selected_candidate'];world={}
                        for field in ('top_center','geometric_body_center'):
                            p=np.asarray(chosen[field+'_camera_m'])
                            q=transform[:3,:3]@p+transform[:3,3]
                            inside=all(sum(e[j]*p[j] for j in range(3))+e[3]<=.005 for e in candidate['fit_camera_hull_equations'])
                            world[field+'_world_m']=q.tolist();world[field+'_inside_FIT_support']=inside
                            world[field+'_maximum_FIT_face_violation_mm']=float(max(
                                (np.dot(e[:3],p)+e[3])/np.linalg.norm(e[:3])*1000
                                for e in candidate['fit_camera_hull_equations']))
                        world['axis_from_top_into_body_world']=(transform[:3,:3]@np.asarray(chosen['axis_from_top_into_body_camera'])).tolist()
                        item.update(world,geometry_candidate_available=True)
p是几何模块输出的相机坐标点,q才是World点;顶端和几何体中心分别保存。FIT凸包检查另存为来源覆盖诊断,不能将“变换矩阵可以计算”直接解释为所有新位置都已有验证数据覆盖。
这套位置候选仍然没有给出灵巧手任意姿态下的完整TCP和接触模型。实际抓取还需要成功姿态的任务绑定。头部俯仰、左右转动,或相机与基座安装改变后,旧TWCTWC不能因为图像还能识别就继续当作正确外参。桌子移近移远本身不会改变相机与基座外参,但工作面、可达性和绑定的假设仍须重新核对。
两层工作面与实时抓取坐标
圆柱几何为什么需要已知尺寸
透视投影下,圆柱顶端的圆会呈椭圆。黑壳几何模块从真实轮廓拟合外缘,并以相机内参和已知半径约束空间圆。图像二次曲线CC可通过KTCKKTCK转到归一化相机坐标,再构造圆位姿候选。对称物体可能有多解,因此还需轴向、轮廓和投影尺寸检查。
红白实现使用扩展ROI、GrabCut前景与彩色种子,结合已确认的直立方向拟合顶缘。它没有把整个YOLO矩形都当作物体。拟合残差、完整外缘和身体投影检查是不同的约束:顶端拟合好,不代表侧面没有选错;检测分类正确,也不保证几何完整。
射线与支撑面求交
若圆柱直立且高度固定,其顶端应落在对应支撑面的等高面上。设相机在World中的原点为OO,某候选点给出的World射线方向为dd,平面由点P0P0和法向nn定义:
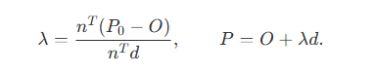
源码 S08 · deployment/visual_equal_height_plane.py · project_observation · L49–L71 · 完整函数;当前射线平面求交。
def project_observation(frame, plane):
    if frame.get('geometry_candidate_available') is not True:
        raise ValueError('Original per-frame rim/body image gates must pass')
    chosen=frame['geometry']['selected_candidate']
    camera_point=np.asarray(chosen['top_center_camera_m'],float)
    transform=np.asarray(plane['world_from_camera'],float)
    normal=np.asarray(plane['axis_from_top_into_body_world'],float)
    origin=transform[:3,3]
    direction=transform[:3,:3]@camera_point
    denominator=float(normal@direction)
    if not np.isfinite(direction).all() or abs(denominator)<1e-9:
        raise ValueError('Camera ray parallel to task plane')
    scale=float(normal@(np.asarray(plane['plane_point_world_m'])-origin)/denominator)
    if not math.isfinite(scale) or scale<=0 or not .1<=scale*camera_point[2]<=2.:
        raise ValueError('Plane intersection behind camera or outside original0.1-2m Z range')
    point=origin+scale*direction
    raw=np.asarray(frame['top_center_world_m'],float)
    body=point+.5*float(frame['geometry']['total_height_mm'])/1000*normal
    return dict(top_center_world_m=point.tolist(),geometric_body_center_world_m=body.tolist(),
        ray_scale=scale,raw_free3D_to_plane_correction_mm=float(np.linalg.norm(point-raw)*1000),
        scope='same_upright_shell_equal_seated_top_plane_only',
        height_inferred_from_task_plane=True,independent_depth_measured=False,
        raw_free3D_position_replaced_in_source_record=False,motion_authorized=False,execution_ready=False)
代码中的方向由完整候选点变换而来,不要求预先归一化,因为比例由scale吸收。检查会拒绝近似平行、在相机后方或超出原范围的求交。返回同时保存原自由三维点到平面点的改变量,并明确independent_depth_measured=False。
工作面法向来自参考观测中的圆柱轴向,不是外部测量仪测得的板面法向。这样可以在限定任务内降低单目自由解的波动,但会把参考轴向和工作板固定的假设带入后续结果。
槽底和板顶的高度差是现场量出的9.6mm。板顶假设通过实际高度模型生成新的平面,每个像素射线重新求交,因此XY也可能变化;不能只把一个旧TCP的Z加9.6mm就称为完成视觉测高。
两层判断为何会拒绝一次观测
当前visual_pick_sort_v22_auto_height.py保留两套已测量平面模型,在每帧轮廓上分别拟合,比较像素证据、连续估高和跨帧一致性。采集要求至少8帧且约2秒,坐标重复性限值3mm,顶缘图像质量判据2px。采样上限15秒不包含单帧推理或取帧阻塞,所以不能把15秒当成整个函数的硬实时截止。
3mm描述的是这一组重复观测的离散程度,不是对外部真值的绝对误差。每帧都接近也可能共同偏移;内参、外参和工作面模型中的系统误差不会被重复采样自动消除。
开发中曾增加“整组模型分数”候选以减少单帧翻票,随后伴随其他回归回退到成功基线。本文调查的当前运行链不能被写成已经启用了那个候选规则。历史fix13的测试或日志,不能覆盖当前文件的逐帧判断事实。
视觉点怎样变成机械臂目标
当前映射使用一次实际成功抓起时保存的TCP,以及当时同一空壳的视觉顶端点。新目标采用相对平移:
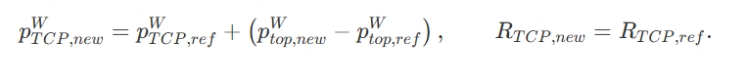
源码 S09 · deployment/visual_pick_sort_v16_source.py · target_candidate · L23–L42 · 完整函数;当前调用的公共目标生成模块。
def target_candidate(point,anchor):
    accepted_anchor(anchor);top=point_checked(point)
    surface=point.get('support_surface')
    expected_plane,rise,digest=support_plane(anchor['equal_height_plane'],surface)
    if (point['binding_camera_context']!=anchor['camera_context']
            or point['equal_height_plane']!=expected_plane
            or point.get('measured_support_rise_mm')!=rise
            or point.get('support_height_model_sha256')!=digest):
        raise ValueError('Target support height/camera/plane differs from its retained image evidence')
    old=anchor['reference_pregrasp_tcp_pose_m_rad'];origin=anchor['reference_top_center_world_m']
    delta=[top[i]-origin[i] for i in range(3)]
    pose=[old[i]+delta[i] for i in range(3)]+old[3:];upper=pose[:];upper[2]+=.180
    return dict(scope='live_visual_translation_from_actual044001_pickup_measured_support',
        pregrasp_tcp_candidate_m_rad=pose,hover_tcp_candidate_m_rad=upper,
        delta_from_reference_world_mm=[v*1000 for v in delta],fixed_wrist_rpy_rad=old[3:],
        prepare_recipe=anchor['prepare_targets'][:],grip_recipe=anchor['grip_targets'][:],lift_mm=180,
        support_surface=surface,measured_support_rise_mm=rise,support_height_model_sha256=digest,
        every_live_ray_reintersected=True,z_only_TCP_offset_used=False,
        slot_lookup_used=False,grid_snap_used=False,old_offsets_applied=False,
        actual_finger_arrival_required=False,motion_authorized=False,execution_ready=False)
这个函数是当前被调用的公共目标生成模块。它验证相机上下文、支撑面来源和绑定,再按本轮视觉差值平移TCP;上方点提高180mm。slot_lookup_used=False和grid_snap_used=False对应的是抓取XYZ,而不是说系统完全没有工作区分区。
一个可追溯的数值例子来自四件批次的cycle002:accepted_candidate.delta_from_reference_world_mm为[1.041314, -0.543378, -0.020730],生成的TCP约为[183.739311, -296.810381, -180.848735] mm,姿态为[-2.144000, -0.006000, 2.166000] rad。同一worker的下降指令保存了相同目标。这里展示的是历史输入差值到动作目标的对应,不是让读者照抄这组坐标控制设备。
近远腕姿选择位于另一层:
源码 S10 · deployment/visual_pick_sort_v22_source.py · select_profile · L86–L98 · 完整函数;当前腕姿分区选择。
def select_profile(point,grid):
    h=grid_matrix(grid,point['binding_camera_context'])
    x,y=foot(point['measurement_bbox_px'])
    denominator=float(h[2,0]*x+h[2,1]*y+h[2,2])
    if abs(denominator)<1e-12:raise ValueError('Image region projection is singular')
    u=float((h[0,0]*x+h[0,1]*y+h[0,2])/denominator)
    v=float((h[1,0]*x+h[1,1]*y+h[1,2])/denominator)
    if not all(math.isfinite(q) for q in (u,v)):raise ValueError('Invalid image region coordinates')
    row=0 if v<.25 else 1 if v<.75 else 2
    col=0 if u<.25 else 1 if u<.75 else 2
    profile='near' if [row,col] in NEAR_CELLS else 'far'
    return profile,dict(row_from_robot_near= row+1,column_from_robot_image_left=col+1,
        image_region_uv=[u,v],profile=profile,XYZ_snapped_to_grid=False)
image_region_uv来自工作区四边形的映射;分区只决定使用哪套已记录腕姿和抓取绑定,不把坐标吸附到槽中心。当前近处区域覆盖最近横向三格及中间横向的两格,实际以配置的机器人视角为准。三维位置仍来自当前目标图像。
这让系统获得了“在限定工作面内根据当前位置抓”的能力,但没有获得所有位置的全局可达保证。红圈区域使用近处手姿时,现场曾报告J3限位;改用远处姿态是否能完成整条路线,仍是未验证的假设。
机械臂和灵巧手怎样完成一轮
六个通道不是六个角度
手部的通道顺序为拇指弯曲、食指、中指、无名指、小拇指、拇指对掌。发送的是0~65535的原始目标计数,不是角度,也没有被标定为夹持力。机械臂位姿位置使用米、姿态使用弧度,关节位置与限位则使用度;把这几套单位混在一起会直接影响运动。
下表取自当前读取的实际成功记录,近处与远处使用同一组手部目标,但机械臂参考姿态不同。它不是早期调试中曾出现的40000等候选值。
这些参数见grasp_success_044001/success_record.json和grasp_near_success_140429/success_record.json。它们属于具体空壳、手姿和现场安装,不可直接作为另一只手的通用配方。
成功记录还保存了六通道速度配置65535、电流上限1299mA和力目标读取值;自动周期主要写位置目标,没有实现基于实时电流调节握持力的外环。电流回读用于状态核对,原始速度计数也没有被换算成指尖线速度。位置、电流、速度三种字段应分别解释。
先下降,再预抓,再夹持提起
这次项目最重要的动作修正之一,是把预抓手型放在下降完成之后。无名指和小拇指在该姿态下已经弯曲,如果在高位就准备好再下降,扫掠形状与实测成功路径会不同。
源码 S11 · deployment/visual_pick_sort_v23_worker.py · main.write_shape · L509–L555 · 完整函数;当前成组手部命令。
    def write_shape(desired,before,label):
        nonlocal motion_poll
        motion_poll=None
        desired=targets(desired);current=targets(before)
        io=bus._io
        if io is None or io.broken or bus._logging_error:
            raise RuntimeError('Current grouped hand connection is unavailable')
        if label=='prepare_after_descent':
            if report['phase']!='preparing_after_descent_at_visual_target' or not report.get('qualified_descent_endpoint'):
                raise RuntimeError('PRE6 is allowed only after this actual visual descent')
        elif label=='grip_together':
            if report['phase']!='grouped_grip_then_immediate180mm_lift' or not report.get('prepare_after_descent_targets'):
                raise RuntimeError('GRIP3 requires this postdescent PRE6')
        elif label=='normal_bin_open':
            if report['phase']!='opening_five_flex_at_current_selected_bin' or not report.get('qualified_bin_endpoint'):
                raise RuntimeError('Five-flex release requires this actual final bin endpoint')
        elif label=='initial_stationary_open':
            if (mode not in ('park_empty','visual_cycle') or active_motion
                    or report['phase']!='opening_current_five_flex_before_arm_motion'
                    or request['scene_permission'].get('initial_stationary_group_open_authorized') is not True
                    or request['scene_permission'].get('initial_opening_and_inert_shell_drop_zone_clear') is not True):
                raise RuntimeError('Initial OPEN5 requires stationary arm and authorized clear opening/drop zone')
        elif label=='empty_travel_open':
            if mode not in ('park_empty','visual_cycle') or report.get('initial_open_posture',{}).get('qualified') is not True:
                raise RuntimeError('Travel requires fresh actual open-position qualification')
        else:raise RuntimeError('Unsupported hand phase')
        address,values=io.groups[label];count=len(values)
        if desired[:count]!=list(values) or any(abs(a-b)>2 for a,b in zip(desired[count:],current[count:])):
            raise RuntimeError('Grouped target values or retained channels differ')
        command=dict(label=label,address=address,num=count,channels=list(range(count)),
            targets=list(values),monotonic=time.monotonic(),attempted=False,acknowledged=False,
            one_group_packet=True,actual_arrival_waited=False)
        report['hand_commands'].append(command)
        if any(abs(a-b)>2 for a,b in zip(current,desired)):
            check_abort()
            if external_drag:raise RuntimeError('External teaching during automatic control')
            bus._serial+=1;io.grant_group(label,bus._serial)
            command['attempted']=True;report['hand_register_writes']+=1
            io.write_group(address,list(values));command['acknowledged']=True
            readback=io.read(1135,6);command['target_readback']=readback
            check_targets(readback,desired,'One complete grouped target write')
            hand_protection_read(label,desired)
        else:command['skipped_matching_targets']=True
        report[label+'_targets']=desired[:]
        report['current_hand_targets']=desired[:]
        append('hand',dict(event='grouped_shape_command',**command));save()
        return desired[:]
write_shape依据阶段选择整组寄存器写入:PRE6写六个通道,GRIP3把拇、食、中三个目标放在同一报文中,投放OPEN5同时打开五个弯曲通道。函数核对写入ACK和目标寄存器回读,但没有把接触后无法完全到达目标的手指强行判定为抓取失败。
这与“忽略全部硬件状态”仍有区别。通信失败、保护异常和执行阶段不合法会阻止继续;真实夹持会使实际位置与目标不同,不能仅凭位置未到达就认定软件有故障。另一方面,写入目标成功也不能证明夹紧,电流、工作状态和现场反馈仍须分别记录。
源码 S12 · deployment/visual_pick_sort_v23_worker.py · main.finish_prepared_pick · L804–L816 · 完整函数;当前夹持和连续提起。
    def finish_prepared_pick(after_prepare):
        report['qualified_prepared_current']=copy.deepcopy(after_prepare)
        phase('grouped_grip_then_immediate180mm_lift')
        write_shape(grip,prepare,'grip_together')
        fresh=qualify_own_hand_hold(report['qualified_descent_endpoint'],'grip Cartesian pose retained')
        upper_pose=fresh['pose'][:];upper_pose[2]+=.180
        upper=move('Movel_Cmd',upper_pose,fresh,drive,grip,'lifting_live_grip180mm')
        report['qualified_loaded_upper']=copy.deepcopy(upper)
        if request.get('wrist_profile')=='near':
            upper=move('Movej_Cmd',scan_reference['joints'][:],upper,drive,grip,
                'carrying_to_verified_common_upper')
            report['qualified_common_loaded_upper']=copy.deepcopy(upper)
        deliver(upper,drive,grip)
finish_prepared_pick先发夹持,再确认机械臂仍在本轮下降点,从当前位姿生成Z增加0.180m的提起目标。中间不要求操作者再按一次键,也不等待三个手指在接触状态下全部到达目标。手指驱动可以继续向其目标闭合,提起过程中接触关系随物体离槽而变化。近处姿态提起后,会先转到已经记录的共同高位再接转运。
这实现了夹持与提起紧接的流程,并不意味着已经具备力控制或滑移闭环。当前没有独立握持传感器确认“稳在手里”;实际成功记录中的holding_sensor_verified=False保留了这一点。
连贯转运需要处理ACK和完成通知
源码 S13 · deployment/visual_pick_sort_v23_worker.py · main.deliver · L755–L763 · 连续截取,非完整函数;当前连贯转运队列的连续片段。
        check_abort();active_motion=True
        for row,flag in zip(rows,[1,1,0]):
            check_abort()
            command=dict(method='Movej_P_Cmd',destination=row['pose'][:],v=TRANSFER_SPEED,
                trajectory_connect=flag,r=0,block=False,phase=row['phase'])
            report['motion_requests'].append(command);report['arm_actuator_writes']+=1;save()
            rc=call('Movej_P_Cmd',row['pose'][:],TRANSFER_SPEED,trajectory_connect=flag,r=0,block=False)
            connected['acknowledgements'].append(rc)
            if type(rc) is not int or rc!=0:raise RuntimeError('Connected transfer ACK refused; no retry/queue flush')
三个投放路径节点以trajectory_connect=[1,1,0]排入控制器,避免每个中间点都回到键盘等待。rc=0只是指令被接受。后续代码还检查完成通知顺序、trajectory_state、最终位姿和连续静稳回读,满足条件后才允许OPEN5。
r=0和block=False也不能写成“保证全程不停顿”。源码明确记录nonzero_corner_velocity_guaranteed=False:当前实现减少的是上层重复等待,没有证明控制器经过所有角点时保持非零速度,更没有完成最优时间轨迹规划。
投放修正与返回路径
黑色进入正常品盒,红白共用白色参考投放位姿。当前配置保存黑色原后移40mm再后移30mm;红白相对白色原位后移55mm、右移-35mm,也就是左移35mm,并把投放高度提高60mm。方向由固定头部视角投影到World XY,再作用于不可变的原始料盒位姿,不随每轮重复累加。
投放后黑色竖直抬80mm,红白抬40mm,再按记录的关节姿态返回。数值以当前color_bin_adjustment_v23.json为准,不把聊天中曾提出但没有进入当前基线的修正当作运行事实。该配置还保留physical_new_drop_acceptance=False,因此配置存在不等于每一处新落点均已实机验收。
源码 S14 · deployment/visual_pick_sort_v23_source.py · adjusted_bin · L93–L127 · 完整函数;当前投放偏移生成。
def adjusted_bin(rows,color,previous_offset):
    setting=json.loads((ROOT/'deployment/color_bin_adjustment_v23.json').read_bytes())
    if setting.get('user_confirmed_additional_not_replacement') is not True:
        raise ValueError('Drop adjustment must retain the confirmed additional-offset semantics')
    transform=json.loads((ROOT/'deployment/camera_position_candidate_225543.json').read_bytes())['world_from_camera']
    backward=[-float(transform[0][2]),-float(transform[1][2]),0.]
    right=[float(transform[0][0]),float(transform[1][0]),0.]
    for axis in (backward,right):
        length=math.hypot(axis[0],axis[1])
        if not math.isfinite(length) or length<1e-9:
            raise ValueError('Fixed robot-view horizontal direction unavailable')
        axis[0]/=length;axis[1]/=length
    current=setting[color]
    back_mm=current['additional_backward_mm'];right_mm=current['additional_right_mm']
    if any(type(v) not in (int,float) or not math.isfinite(v) for v in (back_mm,right_mm)):
        raise ValueError('Drop adjustment must contain finite millimetres')
    delta=[(back_mm*backward[i]+right_mm*right[i])/1000. for i in range(3)]
    up_mm=setting.get('red_white_additional_up_mm',0.) if color in ('red','white') else 0.
    if type(up_mm) not in (int,float) or not math.isfinite(up_mm):raise ValueError('Invalid drop height offset')
    delta[2]+=up_mm/1000.
    previous=rows[-1]['pose'][:]
    for i in range(3):rows[-1]['pose'][i]+=delta[i]
    old=previous_offset['delta_world_mm']
    return rows,dict(target_color=color,scope=setting['scope'],
        source_adjustment_sha256=hashlib.sha256((ROOT/'deployment/color_bin_adjustment_v23.json').read_bytes()).hexdigest(),
        previous_offset=previous_offset,previous_drop_pose_m_rad=previous,
        additional_backward_mm=back_mm,additional_right_mm=right_mm,
        additional_up_mm=up_mm,
        robot_view_backward_unit_World=backward,robot_view_right_unit_World=right,
        additional_delta_world_mm=[v*1000 for v in delta],
        total_delta_from_school_world_mm=[old[i]+delta[i]*1000 for i in range(3)],
        adjusted_drop_pose_m_rad=rows[-1]['pose'][:],
        height_and_orientation_unchanged=up_mm==0,orientation_unchanged=True,
        applied_once_from_immutable_source=True,
        physical_new_drop_acceptance=False)
adjusted_bin把相机视角的“后”和“右”投影成World XY单位方向,再将毫米转换成米。它还保存旧偏移、新增偏移和最终位姿,避免一次次调试后无法回答“这60mm是追加还是替换”。Z方向的提高独立处理,腕姿保持来源值。
高位返回曾被改成笛卡尔直线返回后再调整腕姿,结果出现不同逆解分支、J4逼近限位。当前回到了原成功版本的关节目标返回。这说明“TCP位置相同”不能推出“关节姿态相同”,关节余量也不能只在起点检查一次。
当前安全能力的实际范围
当前启动会读取设备状态,检查碰撞等级8、自碰撞开启、普通关节与驱动限位,以及现场授权条件。历史错误4109对应控制器碰撞保护;恢复软件任务不会自动清除它。3°普通限位余量是度数,不是毫米。
这里没有在线场景障碍地图、点云碰撞体、MoveIt、RRT或其他全局避障规划器。系统使用已记录腕姿、转运走廊、现场清空条件和运行时状态约束。控制器自碰撞功能也不能替代对篮筐、桌面、线缆及抓住物体的完整几何建模。
源码 S15 · deployment/visual_pick_sort_v23_worker.py · main · L1074–L1102 · 连续截取,非完整函数;当前异常处理及主要SDK清理,后续收尾未引用。
    except BaseException as exc:
        report['exceptions'].append(dict(error=repr(exc), traceback=traceback.format_exc(),
            phase=report.get('phase')))
        report.update(failed_phase=report.get('phase'), phase='fault',
            outcome='worker_not_completed_no_automatic_retry', physical_object_success=False)
        if active_motion and robot is not None and not stop_attempted:
            stop_attempted = True
            report['arm_stop_writes'] += 1
            try:
                report['fault_stop_raw'] = call('Move_Stop_Cmd', block=False)
            except BaseException as stop_exc:
                report['fault_stop_error'] = repr(stop_exc)
        save()
    finally:
        if bus is not None:
            try:
                report['hand_close'] = bus.close()
            except BaseException as exc:
                report['cleanup_errors'].append(dict(method='manual_hand_close', error=repr(exc)))
        if robot is not None:
            for name in ('Arm_Socket_Close', 'RM_API_UnInit'):
                try:
                    raw = encode(getattr(robot, name)())
                    report.setdefault('sdk_cleanup_results', []).append(dict(method=name, raw=raw))
                    if name == 'RM_API_UnInit' and (type(raw) is not int or raw != 0):
                        raise RuntimeError('API uninitialization returned nonzero/unknown status')
                except BaseException as exc:
                    report['cleanup_errors'].append(dict(method=name, error=repr(exc)))
            report['SDK_cleanup_finished'] = not report['cleanup_errors']
这段连续源码包含异常记录、一次非阻塞停止请求和主要清理逻辑,后续还有日志与文件锁收尾。Move_Stop_Cmd(block=False)返回、SDK关闭和程序退出都不能证明物理停止;当前基线故障分支仍缺少在断开前保存最终停稳状态的完整证据。故障后默认不自动张开,是因为悬空持物与由板承托时的释放后果不同。现场急停与软件请求的作用不能混用。
Web控制、视频和任务状态
持续画面与定位必须使用同一帧
v24把相机所有权集中到LiveCamera:一个采集线程持有D435,另一个推理线程取最新图像,模型仍在独立进程。网页预览一直更新,动作时也不关闭画面。
显示流是GET /live.mjpg的JPEG帧,压缩和标注只用于观看。几何采集经GET /api/sample取得原始BGR字节与X-Frame-Meta:帧号、单调时钟、内参、原图SHA256和该帧检测结果。SharedMeasurement.wait_for_frames检查哈希、帧号递增和采集时刻,再把同一帧交给几何算法。
如果把某一时刻的框画到另一时刻的图上,页面仍可能“看起来像识别到了”,但ROI和目标像素已经错配。这也是不能拿网页截图替代原始定位输入的原因。
控制按钮对应任务命令
源码 S16 · deployment/visual_task_control_v24.py · RealTaskControl.command · L186–L203 · 连续截取,非完整函数;当前启动命令分支的连续片段。
                elif command in ('START','START_AUTO','START_SINGLE'):
                    if not self.ready or self.busy:
                        raise ValueError('任务尚未就绪或仍在执行,不重复启动')
                    if status['state'] in ('PAUSED','STOPPED','INPUT_UNAVAILABLE','STARTUP_NOT_COMPLETED'):
                        raise ValueError('任务暂停;处理现场状态后可重置软件任务,不能自动重试')
                    cam=status['camera']
                    if not cam['measurement_ready'] or cam['frame_age_seconds'] is None or cam['frame_age_seconds']>1:
                        raise ValueError('实时相机/推理尚未就绪:'+str(cam.get('camera_error') or cam.get('inference_error') or '正在初始化'))
                    if command=='START_AUTO':self.mode='AUTO'
                    if command=='START_SINGLE':self.mode='MANUAL'
                    if self.stop_latch.exists():self.stop_latch.unlink()
                    self.ready=False
                    self.busy=True
                    self.phase='开始当前批次'
                    self.reason=''
                    self._send('a' if self.mode=='AUTO' else 'm')
                elif command=='RESET':
                    if self.busy or not self.ready:
HTTP层通过锁保护任务状态,将自动和单件命令分别转为原批次进程的a或m。忙碌时拒绝重复启动;相机测量数据未就绪或过期时不开始新任务。响应的accepted表示接口接受请求,不表示一轮已经完成。
源码 S17 · deployment/visual_task_control_v24.py · create_server.Handler.do_POST · L300–L320 · 完整函数;当前Web控制API。
        def do_POST(self):
            if urlsplit(self.path).path!='/api/command':
                self.reply(404,dict(error='Unknown route'))
                return
            origin=self.headers.get('Origin')
            if origin and urlsplit(origin).netloc!=self.headers.get('Host'):
                self.reply(403,dict(error='Same-origin commands only'))
                return
            try:
                length=int(self.headers.get('Content-Length','0'))
                if not 0<length<=2048 or self.headers.get('Transfer-Encoding'):
                    raise ValueError('Expected a small JSON command')
                if not self.headers.get('Content-Type','').startswith('application/json'):
                    raise ValueError('Content-Type application/json required')
                body=json.loads(self.rfile.read(length))
                if set(body)!={'command'}:
                    raise ValueError('Only command is accepted')
                value=control.command(body['command'])
                self.reply(value['http_status'],value)
            except (ValueError,TypeError) as exc:
                self.reply(400,dict(error=str(exc)))
真实API只接受/api/command的小型JSON请求,字段必须只有command,并核对来源。服务端不是一个允许任意传入Python、SDK方法名或坐标的执行接口。
网页控制服务监听后台父进程输出,收集PHASE、就绪标记和结果路径,再提供GET /api/status。动作记录留在captures/,包括父进程结果、每轮request.json、worker_result.json、手部JSONL通信和相机压缩包。原图和原始回包用于排错,不能只保留一句“失败”。
“存在2秒才统计”与“采2秒做定位”是两件事
源码 S18 · deployment/visual_detection_confirm_v24.py · ConfirmedDetections.update · L37–L78 · 完整函数;当前显示统计确认。
    def update(self, detections, frame_number, captured):
        # Re-reading the same frame can never make a pending object mature.
        if frame_number<=self.last_frame:
            return self.snapshot
        if (self.last_capture is not None and
                (captured<=self.last_capture or captured-self.last_capture>self.maximum_gap_seconds)):
            self.tracks=[]
        valid=[]
        for index,detection in enumerate(detections):
            box=detection.get('bbox',[])
            category=detection.get('class_id')
            if (type(category) is not int or len(box)!=4
                    or any(type(v) not in (int,float) or not math.isfinite(v) for v in box)
                    or box[2]<=0 or box[3]<=0):
                continue
            valid.append(dict(detection_index=index,class_id=category,bbox=list(box)))
        candidates=[]
        references={}
        for detection in valid:
            options=[i for i,track in enumerate(self.tracks)
                if detection['class_id']==track['class_id']
                and overlap(detection['bbox'],track['bbox'])>=self.minimum_iou]
            candidates.append(options)
            for i in options:references[i]=references.get(i,0)+1
        tracks=[]
        for detection,options in zip(valid,candidates):
            # Ambiguous overlapping objects do not inherit another object's age.
            if len(options)==1 and references[options[0]]==1:
                previous=self.tracks[options[0]]
                identity,first,observations=previous['id'],previous['first_capture'],previous['observations']+1
            else:
                identity,first,observations=self.next_id,captured,1
                self.next_id+=1
            duration=max(0.,captured-first)
            tracks.append(dict(detection,id=identity,first_capture=first,
                observations=observations,visible_seconds=duration,
                confirmed=observations>=2 and duration>=self.required_seconds))
        # Unmatched targets disappear immediately; a later reappearance starts at zero.
        self.tracks=tracks
        self.last_frame,self.last_capture=frame_number,captured
        self.snapshot=self._snapshot(tracks)
        return self.snapshot
ConfirmedDetections.update只处理新采集帧;重复轮询同一帧不会让目标成熟。类别相同、框重叠并且一对一匹配时继承首见时刻;歧义匹配和消失后的重新出现重新计时。达到至少2秒才进入当前可见数量,短暂闪现不计入,也不逐帧累计。
这只影响展示统计。抓取仍要另外完成至少8帧、约2秒的几何采集与坐标检查;绿色确认框不是运动许可。当前统计也不是“今天总共分拣了多少件”的累计产量。
自动批次先按工作区和支持类别筛选;检测列表按图像框X、Y排序用于编号,但执行目标由VisualRecovery.choose决定:优先观测失败次数较少的目标,再按框底部像素Y较大、X较小的顺序选择,也就是图像中的靠前者优先。采集期间锁定本次ROI,保留每帧实际检测框供诊断,不逐帧把新检测框当成新的测量窗口。这里没有按类别价值或最短旅行距离做全局任务排序;这种简单策略保证流程可追溯,但还有效率优化空间。
一个仍未完成的交互缺口
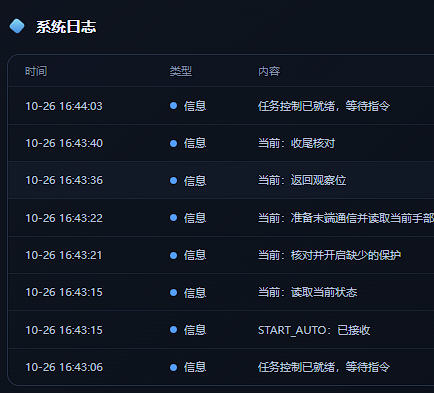
图2:现场反馈中网页停在“收尾核对、等待指令”,后台实际为VISION_PENDING。截图只是日志可见性证据,不代表一轮成功。
2026年10月26日的记录里,相机连续检出一个红色目标,但三组几何采集失败,批次完成数为0。控制服务没有把具体轮廓失败原因完整呈现在主日志中;随后软件重置可以显示IDLE。识别框存在、界面恢复空闲、任务真正抓完,是三种不同状态。这一问题已进入维护计划,尚未修复。
v25:在任务层增加语音和文字
本地最新提交增加了v25候选:笔记本浏览器提供麦克风,经机器人上的HTTPS服务完成语音识别和文字交互,保留原v24画面、按钮和动作执行器。它不是重新写一套机械臂控制程序,也没有给语言模型直接发送关节或手指指令的权限。
浏览器音频与意图接口
浏览器使用AudioWorklet收集音频,重采样为单声道16kHz、PCM16小端数据。UI单句最长20秒,服务器音频限制为30秒;配置支持普通话与英语的ASR参数。后台调用百度ASR,再把非精确口令的文字交给配置的火山方舟Chat接口。实际模型由model_id决定,当前没有锁定可复现的模型修订号。
语言模型拿不到实时图像和设备测量值,只能输出白名单任务意图;它不能从“抓红色那个”生成项目尚未提供的按类别选目标能力。
源码 S19 · deployment/voice_interaction_v25.py · Interaction.execute · L128–L142 · 完整函数;v25候选,未真机验收。
    def execute(self, command, generation=None):
        with self.lock:
            if generation is not None and generation!=self.generation:
                raise InteractionError('This input was cancelled by a stop request; submit a new command')
            if command not in COMMANDS or command=='NONE':
                raise InteractionError('Unsupported command')
            if command not in ('STATUS','STOP') and self.cfg.get('enable_interaction_commands') is not True:
                raise InteractionError('Voice/text motion commands are disabled in the robot configuration')
            if command=='STOP':
                self.stop_generation()
            # Reuse every existing readiness/scene/busy/stop check / 复用原任务门控。
            outcome = self.control.command(command)
        self.log(dict(event='command',command=command,accepted=outcome.get('accepted'),http_status=outcome.get('http_status')))
        return dict(command=command,reply=outcome.get('message','状态已更新'),execution=outcome,
                    executed=bool(outcome.get('accepted')),physical_completion_verified=False)
这段execute最终仍调用self.control.command,复用忙碌、就绪、停止等检查。新增交互的运动命令默认关闭,查询和停止可用。模型提出动作后还有30秒、单次使用的确认;停止会递增取消代次,让迟到网络结果失效。它限制的是任务层权限,不能代替动作层的设备检查。
“停止”按钮直接走原控制接口,不等待ASR或模型。语音“停止”仍受录音、网络与识别延迟影响,不能作为现场硬件急停。
HTTPS、局域网与验证边界
候选层内部HTTP仅监听回环18081端口,外部HTTPS默认监听所有IPv4网卡的18082端口。0.0.0.0是监听含义,不是客户地址,也不代表证书匹配所有IP。证书SAN应包含实际访问的IP或域名,客户只安装管理员核对过的公开根证书;CA私钥、服务端私钥和云Key不进入源码包。
v25还增加HTTP Basic访问口令和同源检查,v24本身的普通HTTP入口不能因此被称为已经具备同样的认证层。两版复用同一个设备进程锁,不应并行启动。
已有验收文件记录了17项模拟接口检查、PCM处理、私有CA下的真实TLS连接验证和包CRC检查。但同一文件明确写着real_cloud=False、real_browser_microphone=False、robot_deployment=False、physical_acceptance=False。所以当前结论是候选源码及离线接口/TLS验证完成,真实云、客户浏览器和真机链路待验收。本文只读取这些既有结果,没有重新运行测试。
结果、指标与验证范围
功能状态矩阵
检测指标:先说数据口径,再给数字
Precision和Recall的定义为:
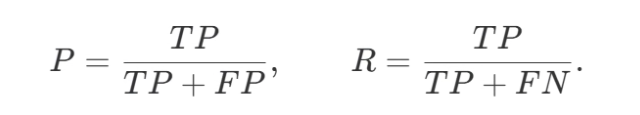
原图v3按类为:黑色293 TP / 2 FP / 0 FN,红色57 / 4 / 1,白色57 / 1 / 0,方形16 / 0 / 0。报告记录过红色窗帘、板孔和黑色杂物的误检,以及遮挡红色目标的漏检。裁剪改变了输入尺度和背景,不能简单从原图误检清单里删掉背景框就当作新的推理实验。
历史训练报告还保存了另一种口径:基础置信度0.25时,v3的P/R为83.60%/99.76%,mAP50为99.39%、mAP50–95为96.91%;v4分别为84.94%/99.76%、99.38%、97.28%。固定阈值P/R和完整PR曲线的mAP不是同一个统计量,也不同于上表采用类别阈值的结果。
上述验证集参与了阈值选择,标注也不是独立盲审真值。数字可以描述该集合中的检测表现,不能外推成所有光照条件的识别率,更不能外推成整机抓取成功率。
定位误差与机械误差不能互换
这里没有可靠的机械臂绝对定位精度测试,不能用厂家宣传值补成项目实测;也没有证据把所有5mm残差归因于肉眼不可见的机械抖动。图像估计、时序、标定和模型约束都可能贡献误差,需要不同实验分开定位。
四件批次与耗时
四件批次审阅确认四个visual_cycle完成,均无记录中的异常和清理错误,自动回观察位;最后一次扫描没有再观察到黑壳,操作者报告“非常完美”。来源包SHA256为6a31f5bd5f86bde3eff767d5dd117432c5d8be07c0a0217cea7d8203a33d2976。
这批记录使用关节移动15%、下降/提起和转运10%,不是当前30%/15%设置。父进程attempts记录的四个动作子进程elapsed_seconds分别为92.625、98.199、98.261、92.375秒,范围92.37~98.26秒。它包括动作进程启动、设备检查、取放和返回,不包含此前的视觉采集,不能叫完整单件端到端耗时;更不能据此按速度比例推算当前节拍。
仍缺少统一统计的指标包括:当前30%/15%版本端到端节拍、实测推理FPS和P95耗时、九槽全覆盖抓取率、混合颜色长批次结果、滑落率、错盒率、持续运行稳定性。没有这些记录的地方,本文不填估计值。
真正遇到的BUG及其处理
1. NumPy布尔值使结果打包崩溃
现象与条件:几何采集完成后,保存JSON时出现Object of type bool_ is not JSON serializable。前面已经采到A或B,并不代表最终结果一定能落盘。
原因与改动:NumPy计算得到的标量进入报告。当前公共记录模块先递归转换数组、标量、容器,再序列化;写文件采用临时文件替换,禁止NaN进入标准JSON。
源码 S20 · deployment/known_cylinder_records.py · native · L8–L21 · 完整函数;当前JSON原生类型转换。
def native(value):
    if value is None or type(value) in (bool, int, float, str):
        return value
    if isinstance(value, dict):
        if any(not isinstance(key, str) for key in value):
            raise TypeError('Record keys must be strings')
        return {key: native(item) for key, item in value.items()}
    if isinstance(value, (list, tuple)):
        return [native(item) for item in value]
    if type(value).__module__.split('.')[0] == 'numpy':
        # Scalars (including bool_) and ndarrays become explicit native values.
        converted = value.tolist() if hasattr(value, 'tolist') else value.item()
        return native(converted)
    raise TypeError('Unsupported record type: '+type(value).__name__)
这段是当前native函数的原样实现。tolist和item负责转回Python类型,嵌套容器继续递归;非有限浮点最终由encode的allow_nan=False拒绝。修复的是结果边界,不应为了让JSON通过而把几何失败改成成功。后续已有可读取的观测和批次报告,但本文没有重新运行该历史采集流程。
2. 机器人重启后,末端寄存器读不到
现象:首次身份读取返回read_state=false,界面只报“手部读取不完整或已过期”。发生在重启后,即使手为空也一样失败。
定位:手是否握物与通信是否配置成功是两件事。原始JSON表明请求还没有进入位置控制,失败在末端Modbus身份寄存器读取。
修复:hand_bus_startup.py在需要时配置控制器末端通信,再核对设备身份,而不是根据“看起来没电池”跳过读取。Git提交75d7ad7记录此修正。它处理配置丢失,不保证以后不会有晚到回包、权限锁存或真正断线。后续每批复用连接的候选又出现过晚到报文,最终仍须按原始事务归属排错。
3. 指令ACK成功,连贯转运仍失败
现象:三个Movej_P_Cmd都返回0,随后出现trajectory_state=false或完成通知不符,物体仍在手中、停在共同高位附近。
定位:ACK是队列受理,不是运动完成。原通知里存在控制器明确的轨迹失败,不能只把它当作“日志顺序不好看”。新增投放点和腕姿也可能超出实际规划能力。
处理:保留原始通知、最终状态和来源高位;红白共用白色位姿,并增加投放高度的候选修正。当前执行器检查1/1/0通知与实际终点后才释放。这个语义检查已经写入代码,但不能由此宣称任意新增投放位姿均可达;当前配置的新落点验收标志仍为false。
4. 为了让返回更好看,反而改变了逆解分支
现象:取放后先直线回观察位置再调腕,J4先接近-175.019°,停止请求之后的后续静态回读约-176.94°;后面恢复原版也在预检报余量不足。
证据:J4故障链复核区分了两个事实:fix14在新增笛卡尔腕姿阶段实际写过动作;后来的fix15和恢复fix11均为0次动作写入,继承了已经停下的残余状态。不能把多次预检拒绝写成多次自主旋转。
改动与边界:撤回固定TCP调腕候选,恢复成功版本记录的关节返回。非阻塞Stop后的最终停稳回读缺口也被单独记录。该缺口没有因为动作回退就自动消失;完整停止轨迹仍缺少数据。经验是优化返回路径时必须比较关节轨迹,不能只比较笛卡尔终点。
5. 0.1mm级机械臂回读变化也打断了流程
现象:下降后预抓阶段报“arm unchanged”不匹配,日志中的位置差约0.100mm,姿态约0.001rad、关节差很小。
定位与处理:原先比较过于精细,把实际回读的微小差异当作阶段变化。当前match_arm和match_cartesian_hold区分笛卡尔保持与关节姿态匹配,位置容差按已授权的1mm处理。它不是允许忽略任何关节越界、姿态变化或9.6mm支撑层选择错误;不同物理量不能共用“没超过1mm”的说法。
6. 标准输入失效后反复刷“任务暂停”
现象:终端循环出现input(): lost sys.stdin,程序保留界面但无法继续交互。
修复:4115500对应控制台输入收尾:把输入不可用作为一次明确状态处理,而不是在捕获异常后原地重复调用input()。后续网页通过受控父进程管道发送任务命令,仍需记录子进程是否退出、是否就绪;不能把进程存在视为设备可用。
7. 白壳被身体图像轴的保守门限拒绝
现象:同一白色圆柱的部分帧报Body image axis ambiguous; principal variance ratio below new conservative2:1 gate,其他帧可解,整组因此失败。
修正:透视、明亮侧面和标签影响了轮廓PCA方向;使用已确认直立任务的轴向基准,保留原顶缘质量检查,相关提交为c611494。此后有白色取放现场记录,但这不证明所有颜色轮廓问题都解决;红色ROI越界和身体轮廓不匹配仍在维护记录里。
8. 识别到红壳,三次重观测后仍没有动作
现象:网页出现识别框,但批次0件完成。相机记录分别报Colored foreground reaches expanded ROI; complete rim unavailable与body_silhouette_mismatch,重观测耗尽后保留一个待处理目标。
当前状态:未修复、已搁置。源码中彩色分割ROI和完整外缘门限是排查入口,但缺少本地收到的对应原始相机包,不能声称已经确认是哪一个背景像素或哪段边缘导致。UI没有显示完整原因也是另一个缺陷,应分别处理。
9. 图中某处使用近处腕姿触发J3限位
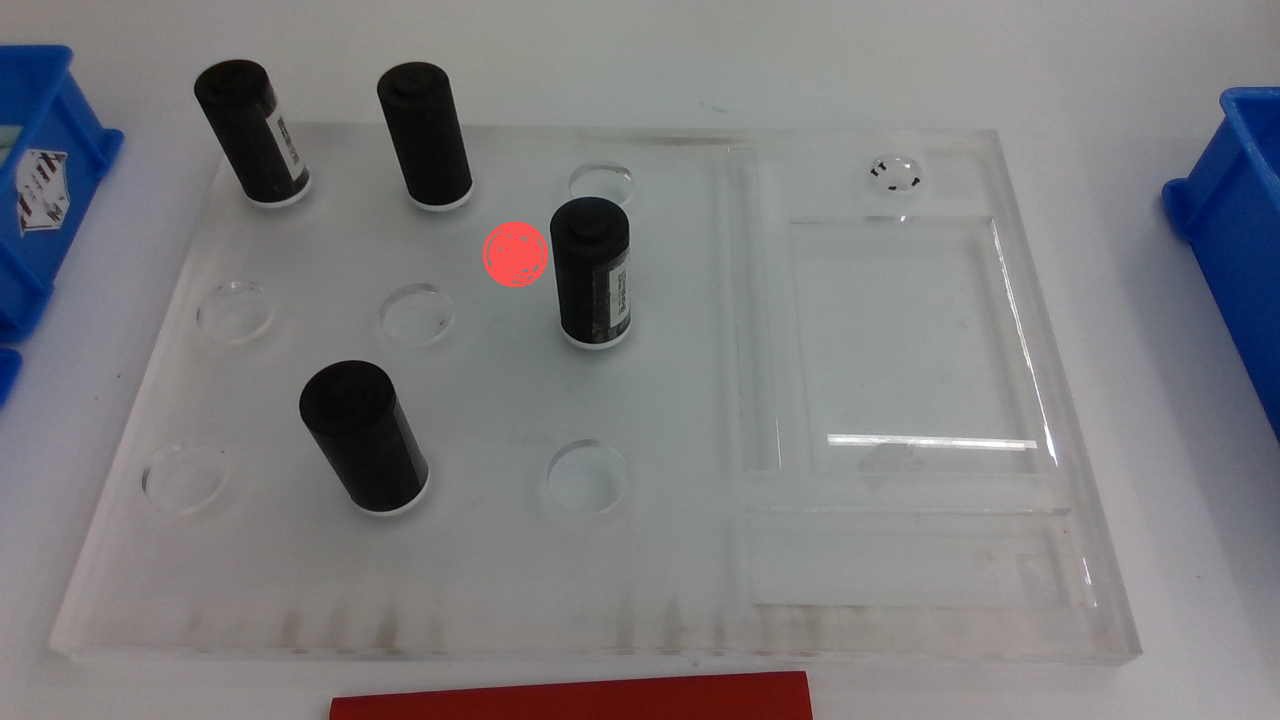
3:现场标记了一个近处腕姿疑似无法完成抓取的位置。图片没有关节读数或World坐标,不能作为远处腕姿安全可用的证明。
当前状态:已记录,未改运行分区。现场报告近处手姿触发第三关节限位,提出远处手姿可能适用;缺少触发阶段、J3实际角度、完整路径与逆解分支日志。下一步应比较两套腕姿从高位、下降、提起到返回的全链,而不是扩大限位或把整片区域直接换成另一姿态。
10. 候选语音HTTPS层中的慢握手问题
v25开发记录包含慢TLS握手阻塞服务受理的修复:握手移到请求线程并设置超时,避免未完成握手一直占住主受理路径。已有本地TLS检查证据,尚无客户浏览器、Wi-Fi与真机联合验收。这个问题属于新增候选网络层,不能与历史机械臂报错混为一个“都修好了”的结论。
版本演进与取舍
Git可以确认下列演进节点,但不能证明每次命名为“验收通过”的提交都经过真机。提交描述的范围和证据必须一起读。
项目日期以这些实际记录为准。Git初始化时间不能自动当作立项日期,文件名中的日期也不能单独当作一次现场测试日期。
几次取舍影响了系统形态。RGB-D位置验证未达判据后,改用有明确任务假设的RGB圆柱和平面模型;一次抓取姿势不能覆盖近处区域后,保存独立近处绑定;提高返回轨迹观感引入逆解分支回归后,恢复记录的关节返回;整组高度模型和连接复用候选没有被包装成无条件升级,而是保留回退事实。工程进展需要体现在真实行为改善,不能只看版本号递增。
部署与复现
先区分源码复现与真机复现
公开源码可以用于理解架构和控制逻辑,但仓库不附模型权重、厂商SDK二进制、现场相机标定和成功腕姿绑定。它不是git clone后接上任意机械臂即可运行的通用产品。完整本地工程和公开精简目录也不是同一个仓库工作树。
现有机器人环境优先沿用。新Python环境安装命令原样来自项目README:
python3 -m venv --system-site-packages .venv
source .venv/bin/activate
python -m pip install -r requirements-web.txt
这几行只完成依赖清单安装,不证明设备SDK、SciPy、RealSense驱动、相机权限及TorchScript运行环境已满足。清单未锁定全部版本,且遗漏SciPy,复现者需要按实际源码补齐并记录环境;本文没有修改环境或执行安装。
源码获取命令也来自README:
git clone https://github.com/VincentCassano/vision-guided-robotic-sorting.git
cd vision-guided-robotic-sorting
恢复模型时,应核对docs/ASSETS.md、模型验证JSON、类别映射和权重哈希;恢复SDK时应匹配aarch64与Python接口;标定、near/far绑定、工作区和料盒位姿必须属于同一现场,不能拿本文矩阵直接用于另一台机器人。
当前v24网页入口
在真机部署已准备好、相机和控制器独占、现场整手与含物路线清空的条件下,README中的启动命令是:
/usr/bin/python3 deployment/run_visual_task_control_v24.py --host 0.0.0.0
该命令会启动相机和任务服务,点击任务按钮后才启动动作。不要为了阅读本文在没有设备条件时执行。默认网页地址为本机http://127.0.0.1:18081,局域网客户使用运行主机实际IP的18081端口;hostname -I可查询地址。监听所有网卡不意味着跨网段路由、防火墙和Wi-Fi客户互访必然可用。
默认尝试打开1440×940普通浏览器窗口,不全屏。只启动服务可加--no-browser。如果使用另一Python环境,需要同时指定该环境解释器及--inference-python,避免主服务可用而模型子进程缺库。
启动前会核对运行文件SHA256。修改源码却继续使用旧清单会被拒绝;这种文件完整性错误不是机械臂故障。不要为了跳过校验随便删清单,它同时约束当前动作代码和来源文件的一致性。
ROS桥是可选入口
下面两行同样来自README,仅在已经配置ROS 1环境时使用:
source ~/catkin_ws/devel/setup.bash
/usr/bin/python3 deployment/task_control_ros_v24.py
桥接器通过同一个任务服务控制设备,不应另起第二套SDK控制。历史终端出现过Unable to communicate with master!,它说明当时无法连接ROS Master,不说明相机或手部已经坏了;纯网页路径不依赖该Master。本文没有把ROS桥存在当作ROS联合实机验收。
v25候选的部署入口
v25依赖完整v24基线,不能只拿十个候选文件代替原工程。以下检查命令原样来自v25部署说明:
python3 deployment/run_visual_task_control_v25.py \
  --config "$HOME/.config/sortai-v25/voice.json" \
  --cert "$HOME/.config/sortai-v25/tls-initial/server_private/robot-server.crt" \
  --key "$HOME/.config/sortai-v25/tls-initial/server_private/robot-server.key" \
  --check-only
它只检查文件、私有配置和证书,不启动相机、SDK或动作,也不验证云Key有效性。初次生成CA、初始化私有配置、客户核对并信任公开根证书的完整步骤应按该说明操作;本文不附任何真实凭据。正式启动去掉--check-only之前,还要结束旧v24服务并完成候选层现场验收条件。
启动异常应按所在层定位
退出浏览器不等于退出服务。服务终端的停止请求、SDK清理与现场硬件停止各自有边界;特别是在手中仍有物体时,不应把“重置”当作自动松手或回起点。
GitHub源码与许可证范围
项目名称为Vision-Guided Robotic Grasping and Sorting System,公开仓库为:
VincentCassano/vision-guided-robotic-sorting。
这个地址来自精简公开发布工作树的实际origin,不是根据项目名拼接猜测。本地主工程当前没有remote;归档的公开工作树本地HEAD为3c799dd0e344809e1dc6f7aa5139e158b6b7e882。本文调查基线则为本地主工程main的c3e02ae…。两者不同,本文没有重新查询远端当前HEAD,也没有执行推送,因此不能声称最新v25已经发布到GitHub。
公开目录保留源码、配置结构、中文README、英文说明和项目结构;模型、SDK、现场绑定及完整原始采集继续保留在本地资产或备份中。历史Git对象是本文取证来源,不保证所有历史证据文件也存在于精简公共仓库。
许可证需要单独说明:当前没有为整个项目授予统一开源许可证的根LICENSE。第三方说明明确表示没有在该说明中新增项目级许可。第三方材料的许可证不能自动覆盖自有代码和厂商SDK。更准确的表述是“已公开项目源码”,读者在复制、再发布或商业使用前仍需核对具体权利范围。
尚未完成的工作与可执行的改进
已发现的问题与尚未验证的风险
已发现的问题包括:红色目标分割误拒、部分位置近处腕姿的J3可达性、视觉待处理原因未完整进入Web日志、依赖清单遗漏、停止后最终状态证据不足。它们有实际文件、现场记录或源码依据。
另外一些是当前证据没有覆盖的风险:模型在陌生背景与光照下的泛化、长时间连续运行中的通信稳定性、不同摩擦表面上的夹持可靠性、改变电池规格后的几何适配。它们不能写成已经发生过的故障,也不能因为没有报告就视为通过。
动态避障、更多规格和双臂协作需要新的状态估计、碰撞模型与控制验证,不能通过多加几个固定点自然获得。若引入规划框架,应先明确它接管哪一段路径、如何保持已有成功姿态和夹持条件,再讨论算法选择。
一个可复现的后续评估方案
以下是建议,没有在本文编写期间执行。
冻结代码、模型、相机参数、标定和动作配置哈希。记录运行主机的Python、PyTorch、OpenCV、SciPy、RealSense与SDK版本。
建立独立标注的检测集,按颜色、背景、遮挡、反光和区域分层;阈值在验证集选定,最终指标在独立测试集报告。
对定位另建测量表,逐点记录真值来源和不确定度,分别统计XYZ偏差、最大误差与重复性。两层不能混入同一个平均误差掩盖错层。
对实际取放逐件记录“检出、定位合格、抓取尝试、确实离面、保持、正确入盒、回观察位”。报告各阶段分母和失败原因,不能以SDK周期完成替代实际入盒。
从用户发起到物体入盒并返回记录完整节拍;相机、推理、几何、设备初始化、每段动作分别计时,报告样本数、中位数与P95。
最后进行约定时长的连续运行,记录重新连接、重复任务、资源占用和人工介入次数。长时稳定性应来自这份记录,不能来自一次演示视频。
这套评估能回答“检测模型是否好”“坐标是否准”“手是否抓住”“整批是否完成”四个不同问题。只有把分母和证据分开,后续提速才不会再次把可靠性回归藏在更流畅的画面后面。
这次开发留下的认识
这个项目已经跨过了单纯显示识别框的阶段:当前目标图像参与坐标生成,机械臂按生成结果完成过实际提起和分类投放,四件黑壳批次也保存了连续处理与最终复查记录。与此同时,它仍是受工作面、物体规格、腕姿和现场走廊约束的原型,不能因有了网页和语言模型就把这些约束抹掉。
最消耗开发时间的部分,是各模块对“成功”的定义不一致。视觉模块得到一个中心,动作模块需要完整TCP;手部确认目标寄存器,机械臂却需要物体确实离面;控制器接受一组指令,网页又可能把接口接收显示成任务完成。把这些语义明确下来,比再加一个功能按钮更能减少误判。
另一条经验来自回归:局部看起来更合理的返回直线,可能换了逆解分支;减少连接时间的候选,可能引入晚到报文;更保守的图像判据,也可能把本来可操作的目标长期拒绝。优化必须保留成功基线,并能对照相同条件下的证据说明到底改善了什么。
项目启动时保留了一句“世上无难事,只要肯登攀。”这句提醒最终应落在可追溯的工程工作里:能够解释某次动作为什么发生、某次失败停在哪一层、一次成功究竟覆盖了什么范围。这样的记录,才使下一次修改有可靠的起点。
阅读与取证入口:源码与证据索引、原图与历史材料、代码引用索引。本文全部项目代码片段按原文件连续行摘录,未改写变量、缩进和执行顺序;部署命令与目录树是明确标注的说明材料。文章未自动发布,本文档检查也不属于真机验收。